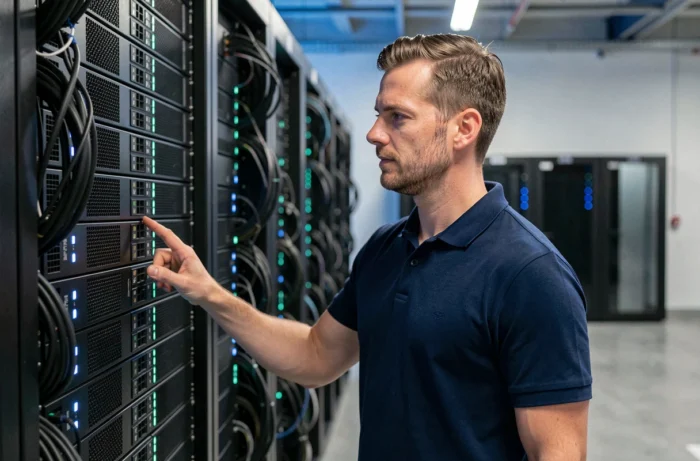
Un cluster informatico riunisce diverse macchine interconnesse che funzionano come un sistema unico. Questa architettura, a lungo riservata alla ricerca scientifica e ai supercomputer, si è democratizzata con la diminuzione dei costi dell’hardware e l’esplosione dei volumi di dati. Le aziende vi ricorrono per esigenze varie, dal calcolo intensivo alla continuità del servizio.
Obbligo di reporting energetico: cosa cambia la normativa europea per i cluster
Gli articoli dedicati ai cluster si limitano spesso alla meccanica tecnica. Tacciono su un quadro normativo che modifica direttamente le scelte infrastrutturali delle aziende europee.
Da quando è stata riformulata la Direttiva (UE) 2023/1791 sull’efficienza energetica e adottato il Regolamento delegato (UE) 2024/1364, i data center la cui potenza IT installata supera 500 kW sono tenuti a dichiarare annualmente i loro indicatori di prestazione energetica. Il PUE (Power Usage Effectiveness), il WUE (Water Usage Effectiveness), la quota di energia rinnovabile e il riutilizzo del calore devono essere trasmessi a un database centralizzato della Commissione europea.
Questi obblighi, applicabili da giugno 2024 in tutti gli Stati membri, riguardano sia i data center aziendali che i siti di co-locazione. Non è prevista alcuna esenzione in base al modello di proprietà. La prima campagna di reporting ha coperto l’anno 2023, con scadenze annuali fissate in primavera.
Per le aziende che gestiscono cluster in loco, ciò significa un monitoraggio documentato del consumo per nodo e per rack. L’architettura del cluster, la scelta del raffreddamento e la densità dei server diventano parametri auditati, non solo decisioni tecniche interne. Comprendere la definizione di un cluster in informatica implica ora integrare questa dimensione normativa sin dalla fase di progettazione.
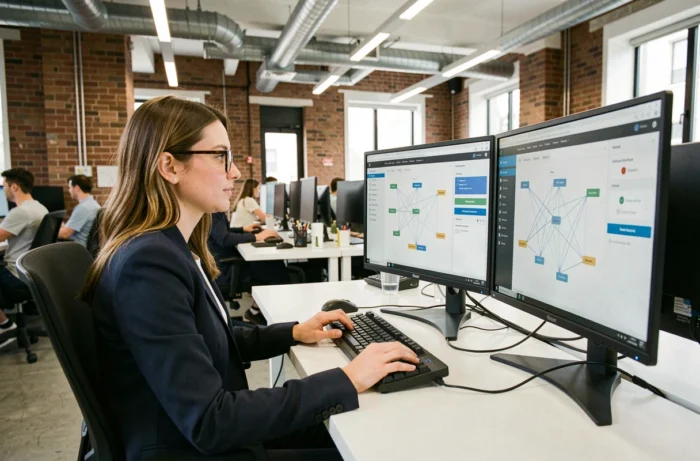
Nodi, rete e gestore delle risorse: anatomia di un cluster
Un cluster è composto da nodi (server fisici o virtuali), da una rete di interconnessione rapida e da un software di gestione che orchestra la distribuzione dei compiti. Ogni nodo dispone del proprio sistema operativo e delle proprie risorse di elaborazione, memoria e archiviazione.
Il gestore delle risorse distribuisce i carichi di lavoro tra i nodi secondo regole configurate dall’amministratore. Se un nodo si guasta, il sistema ridistribuisce i suoi compiti ai nodi rimanenti. Questo meccanismo di failover distingue un cluster da un semplice gruppo di server indipendenti.
Tre configurazioni comuni
- Cluster ad alta disponibilità: nodi di riserva subentrano in caso di guasto del nodo principale. L’obiettivo è ridurre le interruzioni del servizio a pochi secondi, o meno.
- Cluster di calcolo (HPC): i nodi elaborano calcoli in parallelo per accelerare operazioni pesanti, modellazione scientifica, rendering 3D o addestramento di modelli di intelligenza artificiale.
- Cluster di archiviazione distribuita: i dati sono distribuiti e replicati su più nodi. La perdita di un disco o di un server non provoca alcuna perdita di dati.
Queste configurazioni non sono esclusive. Un singolo cluster può combinare alta disponibilità e archiviazione distribuita a seconda delle esigenze dell’azienda.
Cluster fisico, cloud o ibrido: scelte concrete per le aziende
La scelta tra un cluster in loco (bare metal), un cluster cloud o un’architettura ibrida dipende da diversi fattori che i confronti abituali semplificano eccessivamente.
Un cluster fisico offre un controllo totale sull’hardware, sulla latenza di rete e sulla sicurezza dei dati. Tuttavia, richiede un investimento iniziale elevato e un team in grado di gestire l’hardware, gli aggiornamenti del firmware e la sostituzione dei componenti guasti. Il costo di manutenzione rappresenta spesso il carico più sottovalutato nei progetti di cluster in loco.
I grandi fornitori cloud offrono cluster preconfigurati con scalabilità automatica. L’azienda paga in base all’uso e non deve gestire l’hardware. I feedback sul campo divergono su questo punto: alcune aziende constatano che i costi cloud superano quelli di un cluster fisico oltre un certo volume di utilizzo costante, mentre altre vi trovano un risparmio netto grazie all’elasticità.
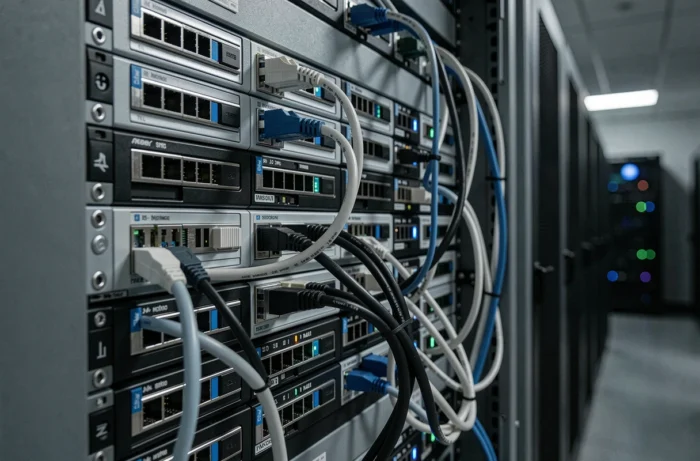
L’approccio ibrido, che combina un cluster locale per i carichi prevedibili e risorse cloud per assorbire i picchi, sta guadagnando terreno. Solleva questioni di orchestrazione: il gestore delle risorse deve coordinare nodi con latenze molto diverse, il che complica la configurazione e il debug.
Kubernetes e orchestrazione dei container: il cluster ripensato
La crescente diffusione di Kubernetes ha modificato il modo in cui le aziende progettano i loro cluster. Invece di distribuire applicazioni direttamente sui server, le impacchettano in container gestiti da un orchestratore.
Kubernetes suddivide il cluster in nodi di lavoro (workers) controllati da un piano di controllo (control plane). L’orchestratore decide dove posizionare ogni container in base alle risorse disponibili, riavvia automaticamente i container guasti e gestisce la scalabilità.
Questo strato di astrazione offre flessibilità, ma aggiunge una complessità intrinseca. Proteggere un cluster Kubernetes richiede competenze distinte rispetto all’amministrazione di sistema tradizionale. Le politiche di rete tra container, la gestione dei segreti e il controllo degli accessi alle API del cluster costituiscono superfici di attacco che i team devono coprire.
Quando Kubernetes non è la risposta
Per un cluster di calcolo HPC a bassa latenza, Kubernetes introduce un sovraccarico (overhead) che può degradare le prestazioni. Le applicazioni di simulazione o modellazione che richiedono una comunicazione ultra-rapida tra nodi rimangono spesso distribuite su cluster HPC tradizionali con interconnessioni specializzate (InfiniBand, ad esempio).
La scelta dello strato di orchestrazione dipende quindi dal tipo di carico di lavoro. Un cluster web ad alto traffico e un cluster di calcolo scientifico non hanno né la stessa architettura né lo stesso gestore.
Etichetta di prestazione europea: una costrizione da anticipare
Oltre al reporting annuale già in vigore, la Commissione europea sta lavorando a un’etichetta di sostenibilità obbligatoria per i data center, comparabile alle etichette energetiche degli elettrodomestici. Questo progetto, basato sull’articolo 33 della Direttiva sull’efficienza energetica, mira alle installazioni la cui potenza IT installata supera 500 kW.
I dati disponibili non consentono di concludere sulla data esatta di attuazione, ma le discussioni prevedono un orizzonte attorno al 2027. Per le aziende che dimensionano un cluster oggi, integrare fin da ora criteri di efficienza energetica nel capitolato evita un costo di conformità successivo.
L’architettura di un cluster non è più solo una questione di potenza di calcolo e ridondanza. Il quadro normativo europeo ne fa anche un tema di conformità energetica, il che ridistribuisce le priorità nelle decisioni infrastrutturali.