Ein Computer-Cluster besteht aus mehreren miteinander verbundenen Maschinen, die als ein einziges System funktionieren. Diese Architektur, die lange Zeit der wissenschaftlichen Forschung und Supercomputern vorbehalten war, hat sich mit dem Rückgang der Hardwarekosten und dem Anstieg der Datenmengen demokratisiert. Unternehmen nutzen sie für verschiedene Bedürfnisse, von rechenintensiven Anwendungen bis hin zur Servicekontinuität.
Berichtspflicht für den Energieverbrauch: Was die europäische Regulierung für Cluster ändert
Die Artikel über Cluster beschränken sich oft auf die technische Mechanik. Sie verschweigen einen regulatorischen Rahmen, der die Infrastrukturentscheidungen europäischer Unternehmen direkt verändert.
Seit der Überarbeitung der Richtlinie (EU) 2023/1791 zur Energieeffizienz und der Annahme der delegierten Verordnung (EU) 2024/1364 sind Rechenzentren mit einer installierten IT-Leistung von über 500 kW verpflichtet, jährlich ihre Energieeffizienzindikatoren zu melden. Der PUE (Power Usage Effectiveness), der WUE (Water Usage Effectiveness), der Anteil erneuerbarer Energien und die Wiederverwendung von Wärme müssen an eine zentrale Datenbank der Europäischen Kommission übermittelt werden.
Diese Verpflichtungen, die seit Juni 2024 in allen Mitgliedstaaten gelten, betreffen sowohl Unternehmensrechenzentren als auch Colocation-Standorte. Es sind keine Ausnahmen je nach Eigentumsmodell vorgesehen. Die erste Berichterstattungskampagne umfasste das Jahr 2023, mit jährlichen Fristen, die im Frühjahr festgelegt wurden.
Für Unternehmen, die Cluster vor Ort betreiben, bedeutet dies eine dokumentierte Überwachung des Verbrauchs pro Knoten und pro Rack. Die Architektur des Clusters, die Wahl der Kühlung und die Dichte der Server werden zu auditierten Parametern, nicht nur zu internen technischen Entscheidungen. Das Verständnis von der Definition eines Clusters in der Informatik erfordert nun, diese regulatorische Dimension bereits in der Entwurfsphase zu integrieren.
Knoten, Netzwerk und Ressourcenmanager: Anatomie eines Clusters
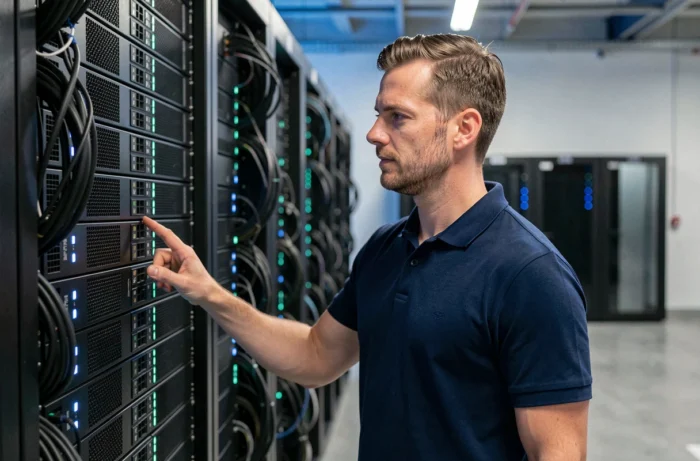
Ein Cluster besteht aus Knoten (physische oder virtuelle Server), einem schnellen Interconnectionsnetzwerk und einer Verwaltungssoftware, die die Verteilung der Aufgaben orchestriert. Jeder Knoten hat sein eigenes Betriebssystem sowie seine eigenen Ressourcen für Prozessor, Speicher und Speicherung.
Der Ressourcenmanager verteilt die Arbeitslasten zwischen den Knoten gemäß den vom Administrator konfigurierten Regeln. Fällt ein Knoten aus, verteilt das System seine Aufgaben auf die verbleibenden Knoten. Dieser Mechanismus für automatisches Failover unterscheidet einen Cluster von einer einfachen Gruppe unabhängiger Server.
Drei gängige Konfigurationen
- Hochverfügbarkeits-Cluster: Backup-Knoten übernehmen im Falle eines Ausfalls des Hauptknotens. Ziel ist es, die Serviceunterbrechungen auf einige Sekunden oder weniger zu reduzieren.
- HPC-Cluster (High Performance Computing): Die Knoten führen Berechnungen parallel aus, um rechenintensive Operationen, wissenschaftliche Modellierungen, 3D-Rendering oder das Training von KI-Modellen zu beschleunigen.
- Verteiltes Speicher-Cluster: Die Daten werden auf mehrere Knoten verteilt und repliziert. Der Verlust einer Festplatte oder eines Servers führt zu keinem Datenverlust.
Diese Konfigurationen sind nicht exklusiv. Ein Cluster kann Hochverfügbarkeit und verteilten Speicher je nach den Bedürfnissen des Unternehmens kombinieren.
Physischer, Cloud- oder Hybrid-Cluster: Konkrete Entscheidungen für Unternehmen
Die Wahl zwischen einem lokalen Cluster (Bare Metal), einem Cloud-Cluster oder einer hybriden Architektur hängt von mehreren Faktoren ab, die die üblichen Vergleiche übermäßig vereinfachen.
Ein physischer Cluster bietet vollständige Kontrolle über die Hardware, die Netzwerklatenz und die Datensicherheit. Er erfordert jedoch eine hohe Anfangsinvestition und ein Team, das in der Lage ist, die Hardware, Firmware-Updates und den Austausch defekter Komponenten zu verwalten. Die Wartungskosten sind oft die am meisten unterschätzte Belastung in Projekten für lokale Cluster.
Große Cloud-Anbieter bieten vorkonfigurierte Cluster mit automatischer Skalierung an. Das Unternehmen zahlt nach Nutzung und muss sich nicht um die Hardware kümmern. Die Rückmeldungen aus der Praxis sind hier unterschiedlich: Einige Unternehmen stellen fest, dass die Cloud-Kosten die eines physischen Clusters bei einem bestimmten konstanten Nutzungsvolumen übersteigen, während andere darin eine Nettoeinsparung aufgrund der Elastizität sehen.
Der hybride Ansatz, der einen lokalen Cluster für vorhersehbare Lasten und Cloud-Ressourcen zur Abdeckung von Spitzenlasten kombiniert, gewinnt an Bedeutung. Er wirft Fragen zur Orchestrierung auf: Der Ressourcenmanager muss Knoten mit sehr unterschiedlichen Latenzen koordinieren, was die Konfiguration und das Debugging erschwert.
Kubernetes und Container-Orchestrierung: Der neu gedachte Cluster
Der Aufstieg von Kubernetes hat die Art und Weise verändert, wie Unternehmen ihre Cluster entwerfen. Anstatt Anwendungen direkt auf Servern bereitzustellen, verpacken sie diese in von einem Orchestrator verwalteten Containern.
Kubernetes unterteilt den Cluster in Arbeitsknoten (Workers), die von einem Kontrollplan (Control Plane) gesteuert werden. Der Orchestrator entscheidet, wo jeder Container basierend auf den verfügbaren Ressourcen platziert wird, startet fehlerhafte Container automatisch neu und verwaltet die Skalierung.
Diese Abstraktionsschicht bringt Flexibilität, fügt jedoch eine eigene Komplexität hinzu. Die Sicherung eines Kubernetes-Clusters erfordert Fähigkeiten, die sich von der klassischen Systemadministration unterscheiden. Die Netzwerkpolitiken zwischen Containern, das Management von Geheimnissen und die Zugangskontrolle zu den APIs des Clusters stellen Angriffsflächen dar, die die Teams abdecken müssen.
Wann Kubernetes nicht die Antwort ist
Für einen HPC-Cluster mit niedriger Latenz führt Kubernetes zu einem Overhead, der die Leistung beeinträchtigen kann. Anwendungen zur Simulation oder Modellierung, die eine ultraschnelle Kommunikation zwischen Knoten erfordern, werden oft weiterhin auf traditionellen HPC-Clustern mit spezialisierten Interkonnektierungen (z. B. InfiniBand) bereitgestellt.
Die Wahl der Orchestrierungsschicht hängt daher von der Art der Arbeitslast ab. Ein stark frequentierter Web-Cluster und ein wissenschaftlicher Rechencluster haben weder die gleiche Architektur noch den gleichen Manager.
Europäisches Leistungslabel: Eine zu erwartende Verpflichtung
Über den bereits geltenden jährlichen Bericht hinaus arbeitet die Europäische Kommission an einem verpflichtenden Nachhaltigkeitslabel für Rechenzentren, vergleichbar mit den Energieetiketten für Haushaltsgeräte. Dieses Projekt, das auf Artikel 33 der Richtlinie zur Energieeffizienz basiert, richtet sich an Einrichtungen mit einer installierten IT-Leistung von über 500 kW.
Die verfügbaren Daten erlauben keine Schlussfolgerung über das genaue Datum der Umsetzung, aber die Diskussionen sehen einen Horizont um 2027 vor. Für Unternehmen, die heute einen Cluster dimensionieren, ist es ratsam, bereits jetzt Kriterien für die Energieeffizienz in die Spezifikation aufzunehmen, um spätere Kosten für die Einhaltung zu vermeiden.
Die Architektur eines Clusters ist nicht mehr nur eine Frage der Rechenleistung und Redundanz. Der europäische regulatorische Rahmen macht sie auch zu einem Thema der Energieeinhaltung, was die Prioritäten bei Infrastrukturentscheidungen neu verteilt.