Um cluster de computação reúne várias máquinas interconectadas que funcionam como um sistema único. Essa arquitetura, por muito tempo reservada à pesquisa científica e aos supercomputadores, se democratizou com a queda do custo do hardware e a explosão dos volumes de dados. As empresas recorrem a ela para necessidades variadas, desde computação intensiva até continuidade de serviço.
Obrigação de relatório energético: o que muda a regulamentação europeia para os clusters
Os artigos dedicados aos clusters muitas vezes se limitam à mecânica técnica. Eles silenciam sobre um quadro regulatório que modifica diretamente as escolhas de infraestrutura das empresas europeias.
Desde a reformulação da Diretiva (UE) 2023/1791 sobre eficiência energética e a adoção do Regulamento delegado (UE) 2024/1364, os data centers cuja potência de TI instalada excede 500 kW são obrigados a declarar anualmente seus indicadores de desempenho energético. O PUE (Power Usage Effectiveness), o WUE (Water Usage Effectiveness), a parte de energia renovável e a reutilização de calor devem ser enviados a uma base de dados centralizada da Comissão Europeia.
Essas obrigações, aplicáveis desde junho de 2024 em todos os Estados membros, dizem respeito tanto aos data centers empresariais quanto aos sites de colocation. Nenhuma isenção é prevista de acordo com o modelo de propriedade. A primeira campanha de relatório abrangeu o ano de 2023, com prazos anuais estabelecidos na primavera.
Para as empresas que operam clusters no local, isso significa um acompanhamento documentado do consumo por nó e por rack. A arquitetura do cluster, a escolha do resfriamento e a densidade dos servidores se tornam parâmetros auditados, não apenas decisões técnicas internas. Compreender a definição de um cluster em computação agora pressupõe integrar essa dimensão regulatória desde a fase de concepção.
Nós, rede e gerenciador de recursos: anatomia de um cluster
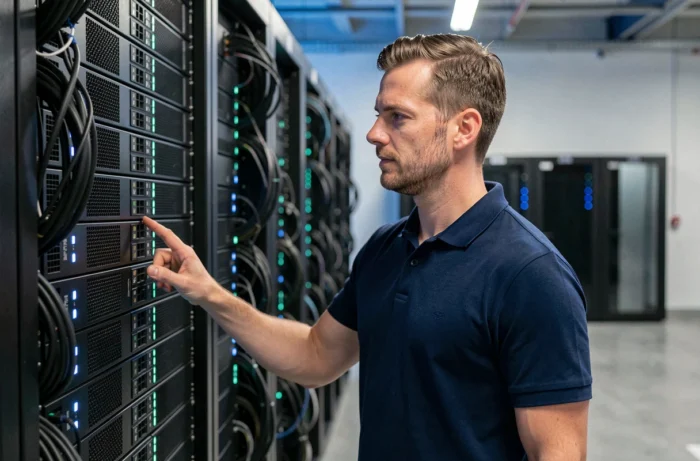
Um cluster é composto por nós (servidores físicos ou virtuais), uma rede de interconexão rápida e um software de gestão que orquestra a distribuição das tarefas. Cada nó possui seu próprio sistema operacional e seus recursos de processador, memória e armazenamento.
O gerenciador de recursos distribui as cargas de trabalho entre os nós de acordo com regras configuradas pelo administrador. Se um nó falhar, o sistema redistribui suas tarefas para os nós restantes. Esse mecanismo de failover distingue um cluster de um simples grupo de servidores independentes.
Três configurações comuns
- Cluster de alta disponibilidade: nós de backup assumem o controle em caso de falha do nó principal. O objetivo é reduzir as interrupções de serviço a alguns segundos, ou até menos.
- Cluster de computação (HPC): os nós processam cálculos em paralelo para acelerar operações pesadas, modelagem científica, renderização 3D ou treinamento de modelos de inteligência artificial.
- Cluster de armazenamento distribuído: os dados são distribuídos e replicados em vários nós. A perda de um disco ou de um servidor não provoca perda de dados.
Essas configurações não são exclusivas. Um mesmo cluster pode combinar alta disponibilidade e armazenamento distribuído de acordo com as necessidades da empresa.
Cluster físico, nuvem ou híbrido: decisões concretas para as empresas
A escolha entre um cluster no local (bare metal), um cluster na nuvem ou uma arquitetura híbrida depende de vários fatores que as comparações habituais simplificam em excesso.
Um cluster físico oferece controle total sobre o hardware, a latência da rede e a segurança dos dados. Em contrapartida, impõe um investimento inicial elevado e uma equipe capaz de gerenciar o hardware, as atualizações de firmware e a substituição de componentes com falha. O custo de manutenção muitas vezes representa a carga mais subestimada em projetos de clusters no local.
Os grandes provedores de nuvem oferecem clusters pré-configurados com escalabilidade automática. A empresa paga pelo uso e não precisa gerenciar o hardware. Os retornos de campo divergem nesse ponto: algumas empresas constatam que os custos na nuvem superam os de um cluster físico além de um certo volume de uso constante, enquanto outras encontram uma economia líquida graças à elasticidade.
A abordagem híbrida, que combina um cluster local para cargas previsíveis e recursos de nuvem para absorver picos, está ganhando espaço. Ela levanta questões de orquestração: o gerenciador de recursos deve coordenar nós com latências muito diferentes, o que complica a configuração e a depuração.
Kubernetes e orquestração de contêineres: o cluster repensado
A ascensão do Kubernetes mudou a forma como as empresas projetam seus clusters. Em vez de implantar aplicativos diretamente em servidores, elas os empacotam em contêineres gerenciados por um orquestrador.
O Kubernetes divide o cluster em nós de trabalho (workers) controlados por um plano de controle (control plane). O orquestrador decide onde colocar cada contêiner com base nos recursos disponíveis, reinicia automaticamente os contêineres com falha e gerencia a escalabilidade.
Essa camada de abstração traz flexibilidade, mas adiciona uma complexidade própria. Proteger um cluster Kubernetes exige competências distintas da administração de sistemas clássica. As políticas de rede entre contêineres, a gestão de segredos e o controle de acesso às APIs do cluster constituem superfícies de ataque que as equipes devem cobrir.
Quando o Kubernetes não é a resposta
Para um cluster de computação HPC de baixa latência, o Kubernetes introduz um custo adicional (overhead) que pode degradar o desempenho. Aplicativos de simulação ou modelagem que exigem comunicação ultra-rápida entre nós geralmente permanecem implantados em clusters HPC tradicionais com interconexões especializadas (InfiniBand, por exemplo).
A escolha da camada de orquestração depende, portanto, do tipo de carga de trabalho. Um cluster web de alto tráfego e um cluster de computação científica não têm a mesma arquitetura nem o mesmo gerenciador.
Rótulo de desempenho europeu: uma restrição a ser antecipada
Além do relatório anual já em vigor, a Comissão Europeia está trabalhando em um rótulo de sustentabilidade obrigatório para os data centers, comparável às etiquetas de energia dos aparelhos domésticos. Este projeto, baseado no artigo 33 da Diretiva sobre eficiência energética, visa instalações cuja potência de TI instalada excede 500 kW.
Os dados disponíveis não permitem concluir sobre a data exata de implementação, mas as discussões preveem um horizonte em torno de 2027. Para as empresas que estão dimensionando um cluster hoje, integrar desde agora critérios de eficiência energética no caderno de encargos evita um custo de conformidade posterior.
A arquitetura de um cluster não é mais apenas uma questão de potência de computação e redundância. O quadro regulatório europeu também a transforma em um assunto de conformidade energética, redistribuindo as prioridades nas decisões de infraestrutura.